
TypeSafe AI a lancé Jev mi-septembre 2026, un modèle positionné sur un créneau inhabituel. Là où les grands modèles de langage génèrent des paragraphes entiers, Jev renvoie des décisions structurées accompagnées de probabilités et d’estimations de confiance. Sa latence de bout en bout est annoncée entre 70 et 500 millisecondes.
📌 L’essentiel en 3 points
- Jev est un modèle de décision structurée lancé par TypeSafe AI le 15 septembre 2026, avec une latence annoncée entre 70 et 500 millisecondes.
- Son prix est de 0,042 dollar par million de tokens en entrée, tandis que les sorties ne sont pas facturées.
- TypeSafe AI avance un coût 444,6 fois inférieur et une exécution 193,6 fois plus rapide dans ses propres évaluations ; ces chiffres restent à confirmer par des tests indépendants.
Cette approche renonce à la génération de texte libre au profit de sorties typées, directement exploitables par un logiciel. Jev ne rédige donc pas un article et ne génère pas de code sous forme textuelle car son domaine est celui de la décision structurée.
Des prix qui défient la raison
Le positionnement tarifaire est particulièrement agressif. En effet, TypeSafe AI affiche un prix de 0,042 dollar par million de tokens en entrée et aucun coût pour les tokens de sortie.
Dans ses propres évaluations de workflows « System One », l’entreprise avance un coût 444 fois inférieur et une exécution 193 fois plus rapide que les LLM de référence qu’elle a retenus. Attention, ces chiffres ne constituent toutefois pas un benchmark indépendant et portent sur des tâches et des conditions définies par l’éditeur.
À ce tarif, avec un crédit de départ de 5 dollars, nous pourrions obtenir théoriquement environ 119 millions de tokens en entrée. De même, le coût de 0,000126 dollar rapporté par un utilisateur pour une demande de scoring en quatre questions ne peut pas être généralisé sans connaître le volume précis de tokens transmis et la configuration de la requête.
Une logique industrielle différente
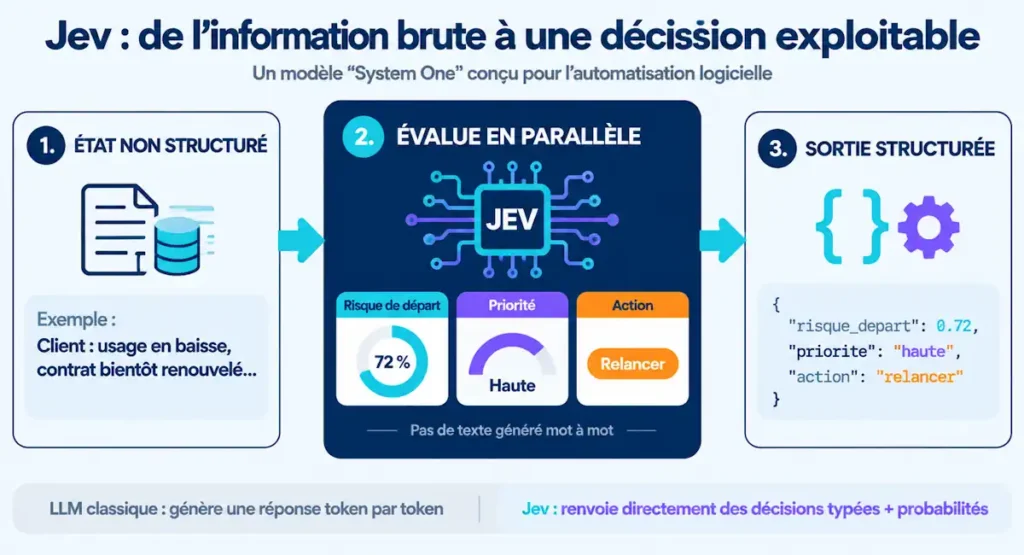
Derrière ces chiffres se trouve une logique industrielle distincte de celle des LLM généralistes. TypeSafe AI présente Jev comme son premier « System One Model ». L’objectif reste l’envoi d’un état et des questions typées, puis de recevoir des décisions structurées.
L’ambition est de fournir aux logiciels des sorties directement utilisables, sans passer par la rédaction d’une réponse en langage naturel. La promesse de réponse en 70 à 500 millisecondes pourrait intéresser les automatisations sensibles à la latence, mais encore une fois, cette performance reste une annonce de l’éditeur. Il faudra certainement vérifier les conditions propres à chaque application.
Des cas d’usage massifs
Le modèle est conçu pour être intégré à des workflows d’automatisation. Le routage de tickets, l’évaluation de contenus, la modération, la qualification ou la recommandation constituent des cas d’usage possibles pour des décisions structurées. Ces exemples montrent bien le positionnement de Jev comme produire des réponses typées, accompagnées de probabilités et de niveaux de confiance, afin que le logiciel appelant puisse prendre en compte l’incertitude de la décision.
Cette spécialisation correspond à la catégorie « System One » revendiquée par TypeSafe AI. Il s’agit à ce stade d’un positionnement d’entreprise, et non d’un segment déjà établi à l’échelle de l’industrie.
Les limites du mirage tarifaire
Les gains annoncés par TypeSafe AI reposent sur ses propres comparaisons et sur des tâches spécifiques. Ils ne permettent toutefois pas de conclure à une supériorité générale de Jev sur les LLM pour l’ensemble des usages.
Jev ne produit donc pas de texte libre. Il ne peut donc pas remplacer un modèle génératif pour rédiger un article ou écrire du code sous forme textuelle. Son champ d’action reste celui de la décision structurée.
Le prix est facturé au volume de tokens envoyé en entrée, tandis que les sorties restent gratuites. La documentation indique par ailleurs une limite de contexte de 64 000 tokens par requête, avec un maximum de 32 000 tokens pour l’état transmis avec la question la plus longue. Pour les documents longs ou les contextes riches, le coût augmente avec la quantité de texte envoyée.
La prudence reste de mise. Les promesses de vitesse et de coût devront être confrontées à des évaluations indépendantes, menées sur des cas d’usage comparables et dans des conditions réelles.
La comparaison ultime entre les LLM et Jev
Deux approches de l’IA
LLM classiques vs Jev : la différence en un coup d’œil
Les LLM sont conçus pour produire du langage. Jev cible plutôt des décisions structurées que des logiciels peuvent exploiter directement.
| Critère | LLM classiques | Jev System One |
|---|---|---|
| But premier | Générer et comprendre du langage : conversation, rédaction, code, raisonnement. | Prendre rapidement des décisions structurées pour une intégration directe dans un logiciel. |
| Sortie | Du texte — parfois du JSON, mais qui doit généralement être interprété puis validé. | Des valeurs typées et probabilisées : catégories, scores, choix ou actions. |
| Mode de génération | Autorégressif : le modèle génère un token après l’autre. | Évalue les sorties de décision en parallèle, plutôt que de composer une phrase token par token. |
| Rapidité | Adaptée à l’échange avec un humain, mais la génération séquentielle peut devenir un goulot d’étranglement dans un workflow. | Conçu pour réduire la latence des appels décisionnels répétés dans une application. |
| Fiabilité du format | Une réponse peut être mal formée, contenir une clé imprévue ou nécessiter une gestion des erreurs. | Le schéma de sortie est garanti par conception, selon TypeSafe AI : pas d’erreur de type dans la réponse. |
| Confiance | Peut fournir une estimation de confiance, mais elle n’est pas toujours bien calibrée. | Produit des probabilités pour permettre au logiciel de déclencher des seuils, règles et escalades humaines. |
| Meilleurs cas d’usage | Chatbots, assistants de rédaction, copilotes de code, synthèse, exploration et tâches ouvertes. | Routage de tickets, détection de risque, priorisation, scoring, décisions à grande échelle et automatisation métier. |
| Limite principale | Le texte est très flexible, mais cette liberté exige des garde-fous avant d’automatiser une action. | Renonce à la génération libre de texte : ce n’est pas un remplaçant universel d’un assistant conversationnel. |
À garder en tête : les caractéristiques et gains annoncés pour Jev proviennent de TypeSafe AI, dans le cadre de son lancement en accès anticipé. Ils doivent être vérifiés sur vos propres données, schémas et contraintes de production.
Questions Fréquentes sur Jev
Qu’est-ce que Jev de TypeSafe AI ?
Jev est un modèle d’intelligence artificielle développé par TypeSafe AI. Il est conçu pour répondre à des questions typées avec des décisions structurées, des probabilités et des indicateurs de confiance, plutôt que pour générer du texte libre.
Jev est-il un LLM ?
Jev se distingue des LLM conversationnels par son mode de sortie. Là où un LLM produit généralement du texte, Jev retourne des réponses structurées exploitables directement par une application. TypeSafe AI le présente comme un « System One Model »
Jev est-il réellement plus rapide que les LLM ?
TypeSafe AI annonce une latence de bout en bout comprise entre 70 et 500 millisecondes. L’entreprise revendique également une exécution 193,6 fois plus rapide dans ses propres évaluations. Ces résultats doivent néanmoins être confirmés par des tests indépendants et comparables.
Quel est le prix de Jev ?
La documentation de TypeSafe AI indique un tarif de 0,042 dollar par million de tokens en entrée pour Jev. Les tokens de sortie ne sont pas facturés.
Jev peut-il rédiger des articles ou générer du code ?
Non. Jev ne produit pas de texte libre. Il ne remplace donc pas un LLM génératif pour rédiger un article, répondre sous forme de paragraphe ou générer du code textuel.