
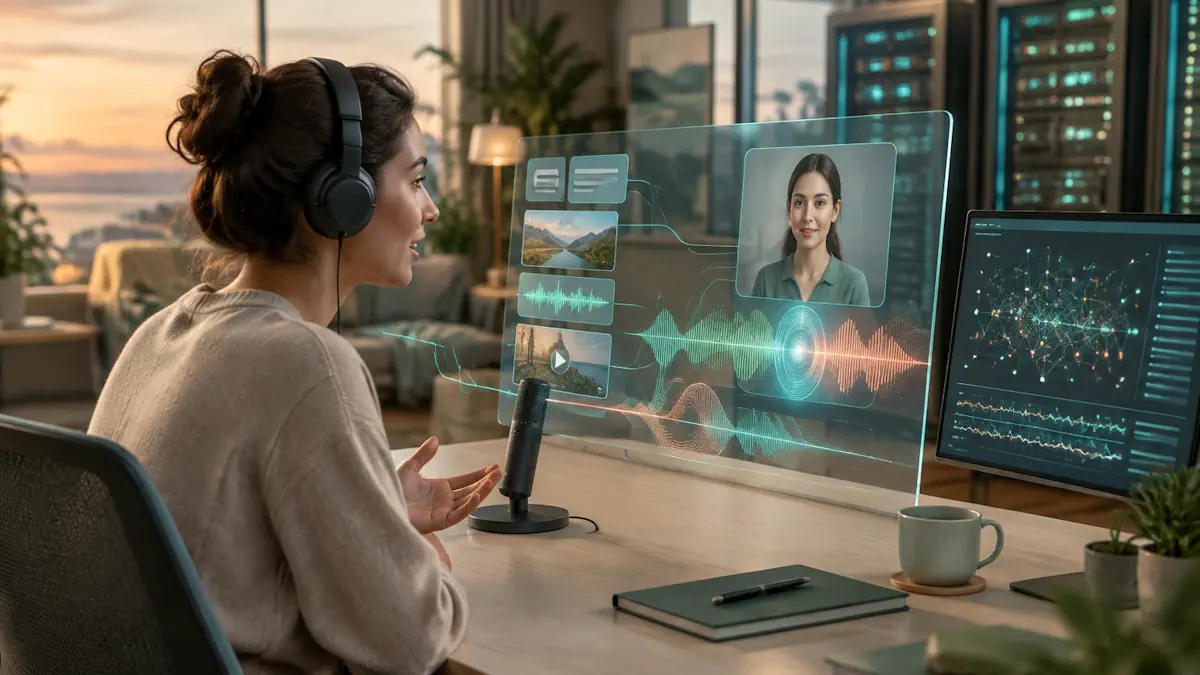
Google fait entrer la voix dans une ère réellement conversationnelle. Deux modèles natifs, Gemini 3.8 Live et Gemini 3.8 Live Extended Thinking, tiennent un échange vocal en temps réel, là où la synthèse vocale se contente de lire un texte. Les développeurs vont vite découvrir que cette fluidité a un coût qui se paie en infrastructure et aussi en questions éthiques.
📌 L’essentiel en 3 points
- Gemini 3.8 Live et Gemini 3.8 Live Extended Thinking ouvrent la voie à des agents vocaux natifs, capables de tenir un échange en temps réel sur du texte, des images, de la vidéo et de l’audio.
- Gemini 3.8 Flash TTS et Flash-Lite TTS promettent des voix expressives en mono ou multi-locuteurs.
- Le coût calculatoire, la profondeur de raisonnement et la gestion des flux WebSocket deviennent les vrais défis d’adoption à grande échelle.
Une voix native, pas un habillage
Gemini 3.8 Live n’est pas le énième module de synthèse vocale qu’il suffit de greffer sur un grand modèle de langage. Il s’agit plutôt d’un modèle natif « speech-to-speech » qui absorbe du texte, des images, de la vidéo et de l’audio. La réponse standard demeure l’audio. Le texte n’arrive qu’en activant la transcription de sortie. L’agent ne passe plus par la chaîne transcription, texte, lecture. Le raisonnement reste en arrière-plan, pendant que la voix continue, ce qui réduit les ruptures et ouvre la voie à des échanges réellement interruptibles.
Gemini 3.8 Live Extended Thinking ajoute un raisonnement de fond, configurable en low, medium ou high, pour les tâches complexes. Le modèle parle pendant qu’il calcule, au lieu de laisser un silence. Les deux modèles passent par la Gemini Live API au moyen d’une connexion WebSocket. Ce choix technique favorise les flux audio bidirectionnels et les agents vocaux toujours à l’écoute, mais il impose une vraie robustesse face aux coupures réseau. Les équipes qui voudraient brancher ce type de modèle sur des centres d’appels ou des assistants vocaux devront toutefois repenser la tolérance aux interruptions et la gestion des sessions longues. Une conversation coupée en plein raisonnement ne produit pas, à elle seule, un journal texte. La transcription d’entrée et de sortie, ainsi que les mises à jour de contenu client, restent les seuls appuis exploitables pour le débogage et le suivi de la qualité.
Le texte vers la voix prend du relief
La documentation officielle de Google mentionne Gemini 3.8 Flash TTS et Gemini 3.8 Flash-Lite TTS, capables de transformer un texte en audio mono-locuteur ou multi-locuteurs. Concrètement, une même phrase peut être portée par plusieurs voix distinctes, avec des intonations plus expressives et une personnalisation fine. Les livres audio, les jeux vidéo et les assistants de marque y trouveront essentiellement un terrain d’expérimentation immédiat.
Cette richesse vocale ouvre aussi une question de traçabilité. Une voix synthétique qui imite plusieurs locuteurs devient plus difficile à distinguer d’un enregistrement humain. Les entreprises qui adoptent ces modèles gagneraient à coupler l’expérience à une politique claire de consentement et d’identification des voix générées.
Bref, la concurrence s’intensifie sur ce terrain. En exposant ces modèles via sa plateforme, Google cherche certes à séduire les créateurs d’agents vocaux mais il place désormais la voix au centre de l’interaction proposée aux développeurs.
Le goulot invisible du temps réel
Chaque échange vocal temps réel sollicite une puissance de calcul dont le coût se répercute rapidement sur les applications à fort volume. Extended Thinking raisonne en arrière-plan et comble l’attente par des relances parlées. Le vrai arbitrage porte sur la profondeur de raisonnement et le coût, et certainement pas sur un silence qui casserait l’échange. Sans cet arbitrage, l’agent vocal parfait deviendrait une démonstration brillante mais coûteuse.
Un assistant vocal sera en mesure de tenir un dialogue, de se laisser interrompre, de reformuler une question et de s’appuyer sur le texte, l’image, la vidéo et l’audio de la session. Le passage du texte vers la voix cesse d’être une simple conversion mécanique, il devient un canal à part entière, aussi riche que l’écrit, mais bien plus exigeant à maîtriser.