
Le développement de modèles d’apprentissage automatique fiables pour la santé peut s’avérer difficile lorsque seuls de petits jeux de données sont disponibles. Ce défi motive des recherches visant à déterminer si les approches de calcul quantique peuvent apprendre des schémas utiles à partir de données limitées sur les symptômes et les facteurs de risque.
Une équipe de recherche, dirigée par Arslan Munir, Ph.D., professeur au département de génie électrique et d’informatique de la Florida Atlantic University, au sein du College of Engineering and Computer Science, et directeur du Intelligent Systems, Computer Architecture, Analytics, and Security Laboratory, a évalué des approches d’apprentissage automatique quantique en simulation et sur matériel quantique à partir de données sur les symptômes et les facteurs de risque pour la prédiction du cancer du poumon dans un contexte de données d’entraînement limitées.
L’étude, publiée dans Discover Quantum Science, une revue de Springer Nature, et intitulée « Inférence du cancer du poumon à partir de données d’apprentissage limitées grâce à des techniques quantiques à base de portes et de recuit », fournit un cadre commun pour évaluer différentes méthodes d’apprentissage automatique quantique dans les mêmes conditions de préparation des données et de test.
« Notre objectif était d’examiner comment différentes approches d’apprentissage quantique se comportent lorsque la quantité de données d’entraînement est délibérément restreinte », a déclaré Munir. « En évaluant plusieurs méthodes au sein d’un cadre expérimental commun, nous pouvons mieux comprendre leurs capacités et leurs limites, et identifier les pistes qui méritent des recherches supplémentaires. »
Les chercheurs sont partis d’un jeu de données accessible au public contenant 309 enregistrements avec des informations telles que les antécédents de tabagisme, la toux, la respiration sifflante, la fatigue et la douleur thoracique, ainsi qu’une étiquette indiquant la présence d’un cancer du poumon. Pour équilibrer les catégories cancer et non-cancer, ils ont utilisé une technique statistique générant des exemples synthétiques, aboutissant à un jeu de données expérimental de 540 échantillons. Ces échantillons supplémentaires ne représentaient pas de patients nouvellement recrutés.
Une méthode de sélection de variables fondée sur l’optimisation a réduit les variables d’entrée à 10. Les chercheurs ont ensuite évalué trois méthodes de classification : les machines à vecteurs de support quantiques, les k plus proches voisins quantiques et le boosting quantique. À chacun des cinq tours d’évaluation, les modèles ont été entraînés sur 108 échantillons et testés sur les 432 restants.
L’étude a examiné deux grandes approches du calcul quantique : le recuit quantique et le calcul à base de portes. L’équipe a évalué des implémentations sur Qiskit, Cirq, PennyLane, OpenJij et D-Wave, ce qui a permis des comparaisons entre plusieurs cadres logiciels et approches de calcul.
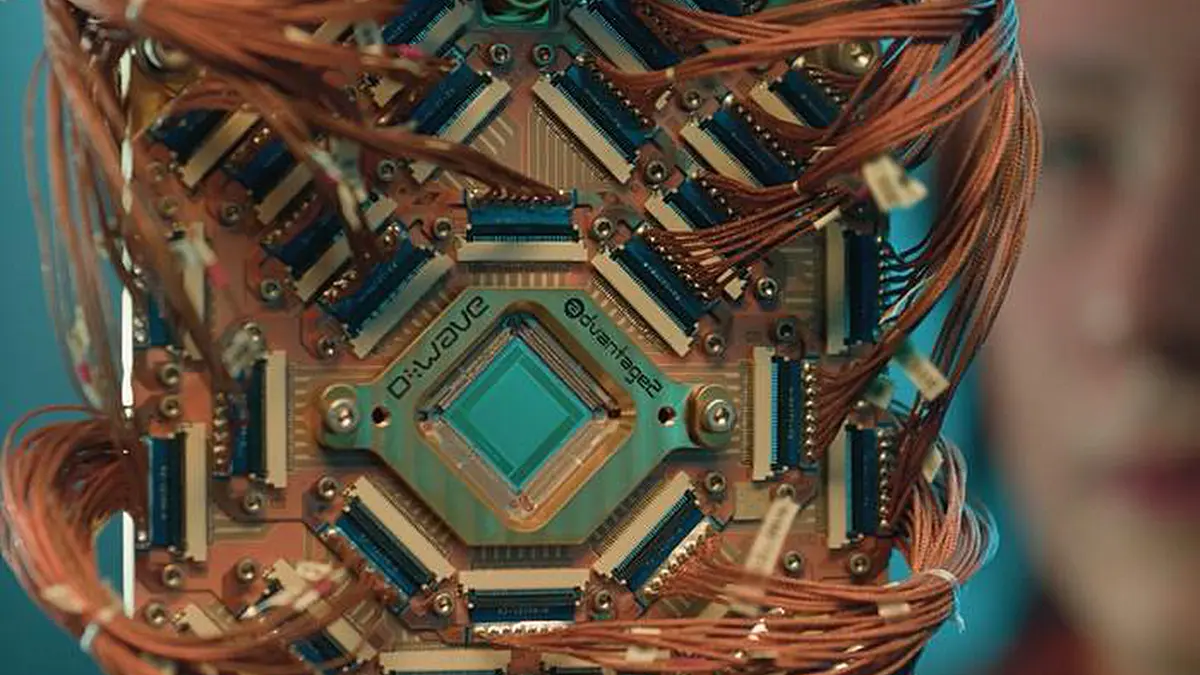
Les ordinateurs quantiques à recuit de D-Wave, utilisés dans un cadre de machine à vecteurs de support quantique, ont obtenu la précision la plus élevée rapportée dans l’évaluation principale, avec 94,31 % en simulation et 91,90 % sur le matériel quantique. Les tests sur matériel ont permis aux chercheurs d’examiner comment la méthode se comportait au-delà d’un environnement simulé.
« Les recherches de la FAU mettent en évidence la manière dont les ordinateurs quantiques à recuit de D-Wave peuvent être utilisés pour faire progresser l’IA et l’apprentissage automatique », a déclaré Catherine Potts, Ph.D., responsable de la gestion technique des comptes chez D-Wave Quantum Inc. « En appliquant notre technologie à un cas d’usage exigeant dans le domaine de la santé, les chercheurs démontrent son potentiel à extraire des informations précieuses dans des environnements limités en données, ouvrant de nouvelles possibilités pour l’IA propulsée par le quantique dans la santé et d’autres industries à forte intensité de données. »
La contribution de l’étude va au-delà de son score de précision le plus élevé. En appliquant un cadre d’évaluation commun, les chercheurs ont examiné comment le choix de la méthode de classification, des variables sélectionnées et de la plateforme de calcul affectait les performances. Les résultats offrent une base pour des recherches plus approfondies sur l’apprentissage automatique quantique appliqué aux données de santé structurées.
« Cette étude reflète les efforts de Florida Atlantic pour relier la recherche en calcul quantique à des questions d’application porteuses de sens », a déclaré Stella Batalama, Ph.D., doyenne du College of Engineering and Computer Science de la FAU. « Des comparaisons rigoureuses et des tests sur matériel quantique aident à constituer les preuves nécessaires pour évaluer où ces technologies peuvent être utiles et quels défis subsistent. »
Les chercheurs soulignent que les résultats sont préliminaires. Le jeu de données contient des symptômes et des facteurs de risque plutôt que des images médicales, des constats anatomopathologiques, des résultats de laboratoire ou des informations sur le stade du cancer. La précision rapportée reflète le jeu de données augmenté de l’étude et sa procédure d’évaluation.
Les recherches futures porteront sur des jeux de données plus vastes provenant de plusieurs institutions et exploreront la combinaison des informations sur les symptômes avec des données d’imagerie ou génomiques. L’équipe prévoit également d’étudier des méthodes rendant les prédictions des modèles plus faciles à interpréter.
« Ces résultats constituent un point de départ pour une évaluation plus approfondie », a déclaré Munir. « L’étape suivante consiste à déterminer dans quelle mesure ces approches se généralisent à des jeux de données cliniques indépendants et si elles peuvent apporter un soutien utile au sein de flux de travail de santé soigneusement validés. »
Article : Inferring lung cancer under limited learning data through gate-based and annealing-based quantum techniques – Journal : Discover Quantum Science – Méthode : Data/statistical analysis – DOI : Lien vers l’étude
Source : Florida Atlantic